
«Краснотека» — электронный архив газет Красноармейска
У маленького города короткая память. Газеты выходят, их читают, потом они оседают в чьих-то шкафах и папках с PDF, а через десять лет найти заметку про открытие школы или снос дома уже почти невозможно.
«Краснотека» — это оцифрованная подшивка газет Красноармейска и краеведческие книги с поиском по каждому слову. Официальное название — «Красноармейский газетный архив». Он открылся 19 июля 2026 года.
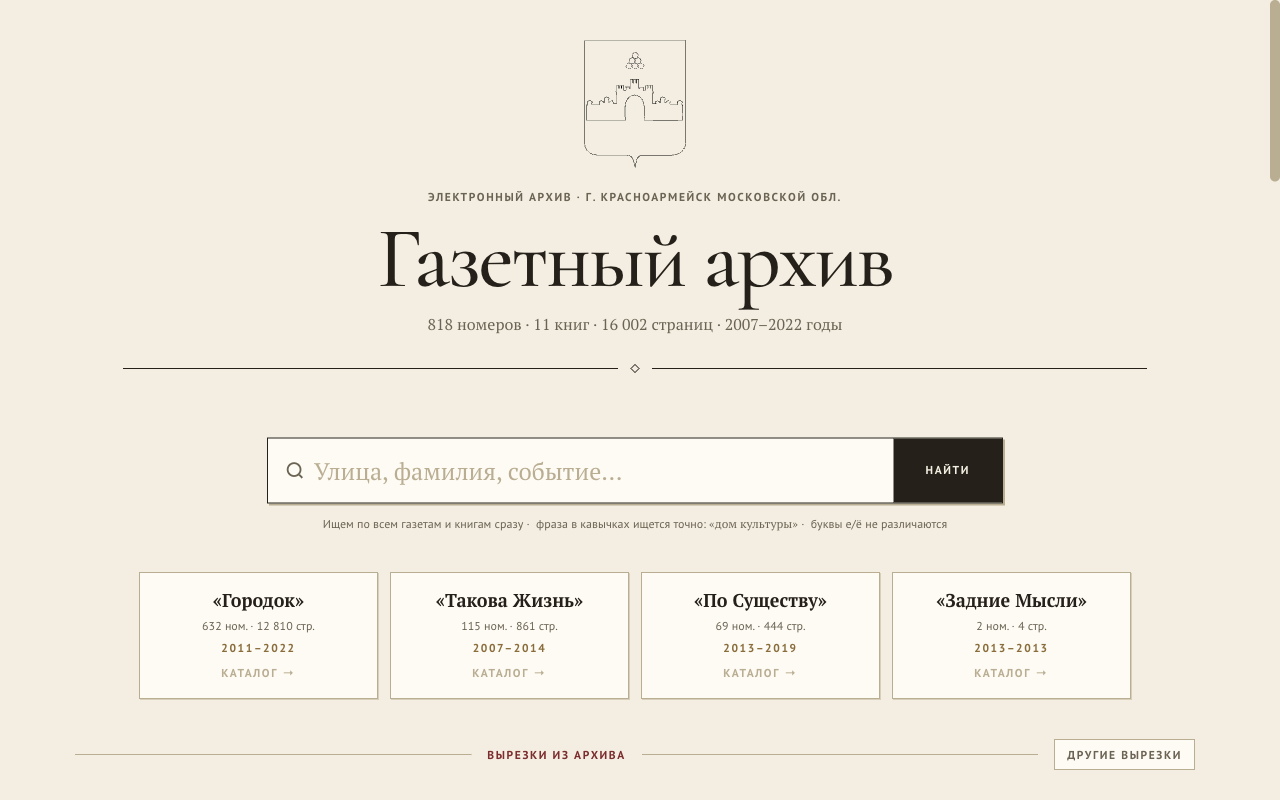
Что внутри
Всего 818 номеров и 14 119 газетных страниц за 2007–2022 годы, плюс 11 книг на 1 883 страницы. В базе больше 120 миллионов символов текста.
- «Городок» — газета, учредителем которой была городская администрация. 632 номера и 12 810 страниц, с января 2011 по март 2022 года.
- «Такова Жизнь» — альтернативное городское издание. 115 номеров, 2007–2014 годы. В первом номере редакция прямо написала, зачем она нужна: для изложения официальной позиции в городе уже выходят две газеты.
- «По Существу» — 69 номеров, 2013–2019 годы.
- «Задние Мысли» — два номера 2013 года.
- Книги: «Живая летопись Красноармейска», «Красноармейск и его окрестности», «О чём рассказывает Воря», «Прошлое земли Красноармейской», «Вознесенская мануфактура», «Фотолетопись Красноармейска», «Довоенная история города в фотографиях», три книги о Софринском артиллерийском полигоне и «Рождение реактивной артиллерии».
Официальная и альтернативная пресса лежат рядом, и это, пожалуй, самое ценное: про одно и то же событие можно прочитать две версии.
Поиск
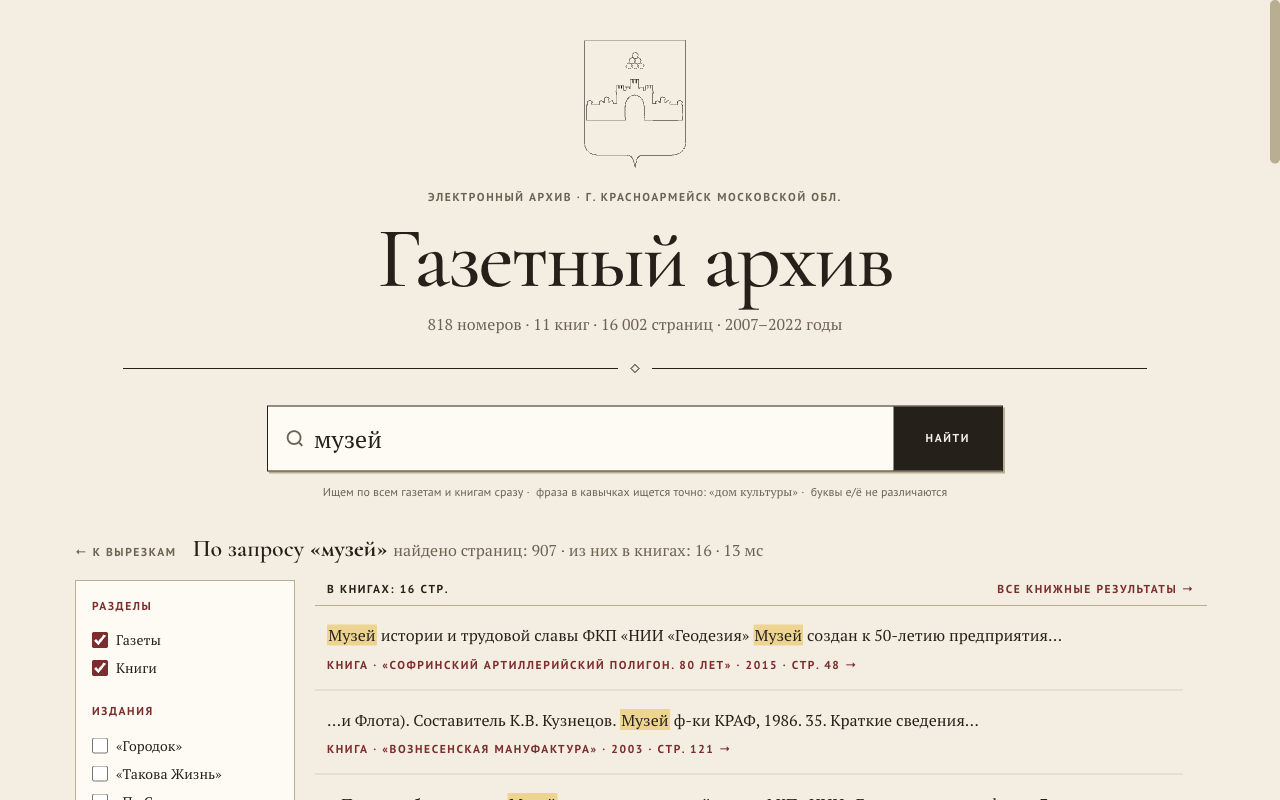
Поиск работает по мере набора: последнее слово ищется по началу, фразы в кавычках — точно, «ё» и «е» не различаются. Можно отфильтровать выдачу по изданиям и годам. Книги показываются отдельным блоком сверху — как в Яндексе, — а газеты лентой ниже.
Запрос «музей» находит больше девятисот страниц примерно за одну седьмую секунды. Открываешь страницу — и найденное слово подсвечено прямо на скане газеты.
Вырезки из архива
Чтобы на главной было что почитать и без поиска, там показываются «вырезки»: случайные фрагменты по два-четыре предложения из разных изданий. Кнопка «Другие вырезки» подбрасывает новые. Внизу страницы — «Летопись перемен», где видно, что и когда появилось в архиве, и благодарности всем, кто помог.
Самое сложное было не в коде
Сканы без текста. Часть номеров и почти все книги — это просто картинки. Их пришлось распознавать, и для этого хватило встроенного распознавания macOS, без платных сервисов: примерно секунда на страницу. Порядок чтения собирается отдельно — блоки, колонки, строки, — иначе газетная вёрстка превращается в кашу. Распознано 862 страницы книг и 91 газетная страница.
Текст, который притворяется текстом. В других PDF текст вроде бы есть, но вместо «Вознесенская» там лежит «Bo3tteceHCKa». Скрипт замечает такие страницы по доле кириллицы и отправляет их на распознавание заново. Старые номера «Такова Жизнь» и вовсе хранились в устаревшей кодировке, и её тоже пришлось чинить.
Дата из телепрограммы. Автоматика брала дату номера из телепрограммы на последней полосе. У одного номера из-за этого съехал даже год, а декоративную дату в шапке распознавание прочитало как «20.03» вместо «28.03». Даты номеров я выверял вручную.
Фото, которое нечего распознавать. Из 43 страниц без текста удалось распознать 42. Последняя — фотография во всю полосу.
Архив собирают люди
Недостающие номера приносят жители. Один читатель передал 25 номеров «Такова Жизнь» за 2013–2014 годы, другой — пропавший номер «Задних Мыслей», третий помог найти и отсканировать редкие книги. Всем им на сайте сказано спасибо.
Выпуск новой партии занимает минут двадцать пять: индексация, прогрев кэша страниц, резервная копия.
В архиве до сих пор нет номеров «Такова Жизнь» с 91 по 101 — это конец 2012 и первая половина 2013 года. Если они у вас есть, напишите мне.
Как устроено
- Исходные PDF с сайта скачать невозможно: страницы отдаются картинками, которые рисуются на лету и складываются в кэш — сейчас в нём около 16 тысяч страниц на 10 гигабайт.
- Поиск — полнотекстовый индекс прямо в базе, без отдельного поискового сервера: всё работает в одном процессе.
- От автоматического выкачивания архив защищён ограничением на число запросов, а поисковым роботам полный текст газет не отдаётся — иначе базу давно бы растащили.
- Всё это работает на старом MacBook у меня дома. Каждую ночь скрипт проверяет, менялось ли что-нибудь, и только тогда отправляет копию в облако: архив растёт рывками, и гонять 16 гигабайт каждую ночь незачем.